AI算法
基于深度强化学习的近视防控动态决策:从多模态数据到自适应光学干预
基于深度强化学习的近视防控动态决策:从多模态数据到自适应光学干预 在近视防控进入精准化、个性化干预的时代,传统的“一刀切”处方模式已难以满足临床需求。面对青少年眼轴的快速变化和复杂的用眼环境,如何动态调整光学干预方案成为关键挑战。深度强化学习(DRL)作为AI领域的一颗新星,正以其独特的“试错-反馈”机制,为近视管理带来算法范式上的突破。 近视防控的“动态迷宫”与DRL的天然匹配 近视进展是一个多因素驱动的时变过程,涉及遗传、环境、光学离焦和双眼视功能等交互作用。临床医生犹如在迷宫中导航,需要根据每次复查的数据(如屈光度、眼轴长度、角膜地形图、患者依从性)调整治疗路径。DRL通过构建智能体(Agent),在模拟环境中不断尝试各种干预组合(如角膜塑形镜参数、多焦点软镜附加度数、阿托品浓度),并根据眼轴增长速率的奖励信号优化策略。这种闭环学习恰好契合了近视管理的序贯决策本质。 近期一项发表于《眼科与视觉科学研究》的研究中,研究人员利用历史眼轴数据和环境因素构建了一个虚拟儿童近视进展环境。DRL智能体经过数万次模拟试验后,能够针对不同基线特征的患者,生成个性化的季度光学干预调整方案。...
# 基于深度强化学习的近视防控动态决策:从多模态数据到自适应光学干预
在近视防控进入精准化、个性化干预的时代,传统的“一刀切”处方模式已难以满足临床需求。面对青少年眼轴的快速变化和复杂的用眼环境,如何动态调整光学干预方案成为关键挑战。深度强化学习(DRL)作为AI领域的一颗新星,正以其独特的“试错-反馈”机制,为近视管理带来算法范式上的突破。
## 近视防控的“动态迷宫”与DRL的天然匹配
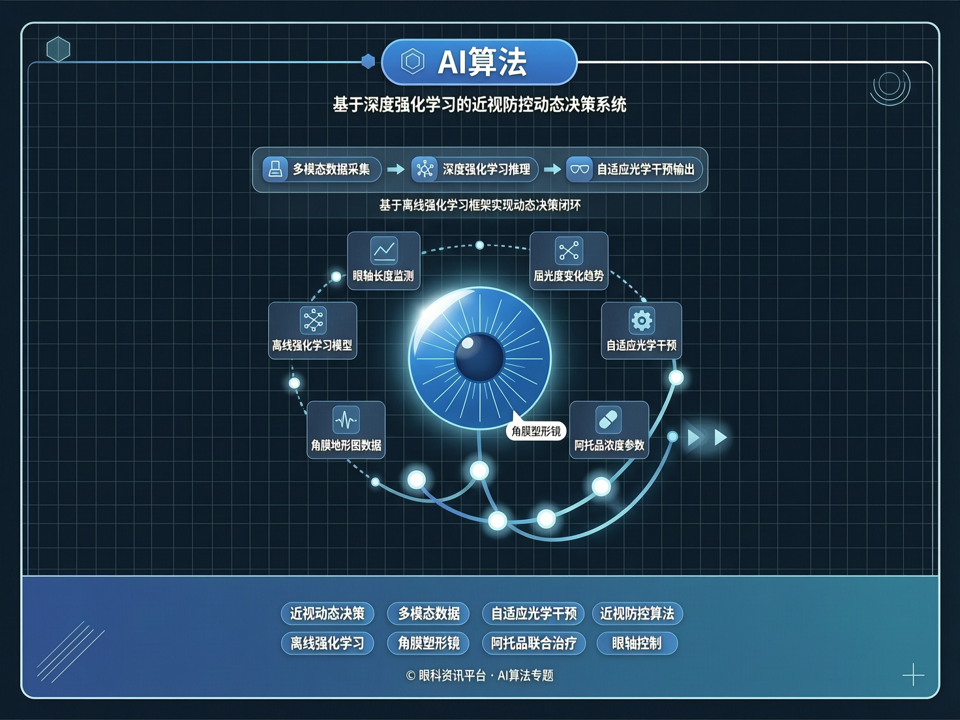
近视进展是一个多因素驱动的时变过程,涉及遗传、环境、光学离焦和双眼视功能等交互作用。临床医生犹如在迷宫中导航,需要根据每次复查的数据(如屈光度、眼轴长度、角膜地形图、患者依从性)调整治疗路径。DRL通过构建智能体(Agent),在模拟环境中不断尝试各种干预组合(如角膜塑形镜参数、多焦点软镜附加度数、阿托品浓度),并根据眼轴增长速率的奖励信号优化策略。这种闭环学习恰好契合了近视管理的序贯决策本质。
近期一项发表于《眼科与视觉科学研究》的研究中,研究人员利用历史眼轴数据和环境因素构建了一个虚拟儿童近视进展环境。DRL智能体经过数万次模拟试验后,能够针对不同基线特征的患者,生成个性化的季度光学干预调整方案。其5年模拟结果相较于固定治疗组,眼轴增长减缓了约0.12mm,显示出在长期管理中的潜力。
## 多模态输入拓宽状态空间
为了更精准地刻画“状态”,现代DRL模型不再局限于屈光度和眼轴,而是融合了多模态数据。角膜地形图通过卷积神经网络提取高阶像差特征,OCT血管成像提供脉络膜厚度和血流密度信息,甚至连可穿戴设备记录的户外活动时间和近距离用眼距离也被纳入状态向量。这种丰富的表征使智能体能够感知到更细微的近视进展风险,例如,当脉络膜变薄速度加快而户外暴露不足时,模型会主动推荐增加光学离焦量或启动低浓度阿托品联合治疗。
## 从仿真到临床的迁移壁垒与破解
尽管DRL在仿真中表现优异,但向真实世界迁移面临挑战:个体对干预的反应存在异质性,且安全探索不可行。当前解决方案是结合离线强化学习,利用大量历史配镜和验配数据进行批量学习,避免在线试错风险。同时,通过因果推断剔除混杂因素,构建结构因果模型来指导探索方向,使推荐策略更符合眼科生理逻辑。
## 自适应光学干预的操作化
DRL的输出不再是一成不变的处方,而是一系列“if-then”规则。例如,若6个月眼轴增长>0.15mm且瞳孔直径偏大,则建议更换更大光学区的镜片设计并联合0.01%阿托品。这种决策可以嵌入视光中心的电子病历系统,实时为验光师提供动态调整建议。未来,随着智能光学器具(如可调焦眼镜)的普及,DRL甚至可以驱动器件自动改变光学剖面,实现按日或按周的自适应调控。
## 挑战与方向
眼科DRL的进一步发展需解决数据标准化、模型可解释性和跨中心泛化问题。目前,开源工具如OpenAI Gym已出现定制化的近视防控环境,但缺乏大规模多中心验证。可解释性方面,注意力机制和Shapley值可被用于解释模型对哪些特征赋予高权重,增强临床信任。
深度强化学习正在为近视防控打开一扇“自适应”的窗口,让算法从辅助诊断走向决策驱动。当智能体学会在数百万次虚拟眼轴演化中寻找最优路径时,我们离真正的精准近视管理又近了一步。